Jev, qu'est-ce que c'est ? Le guide complet
Jev est un modèle d'IA qui ne rédige rien : il décide. Ce que c'est, comment ça marche, ses limites, et comment y accéder par OpenRouter ou TypeSafe.

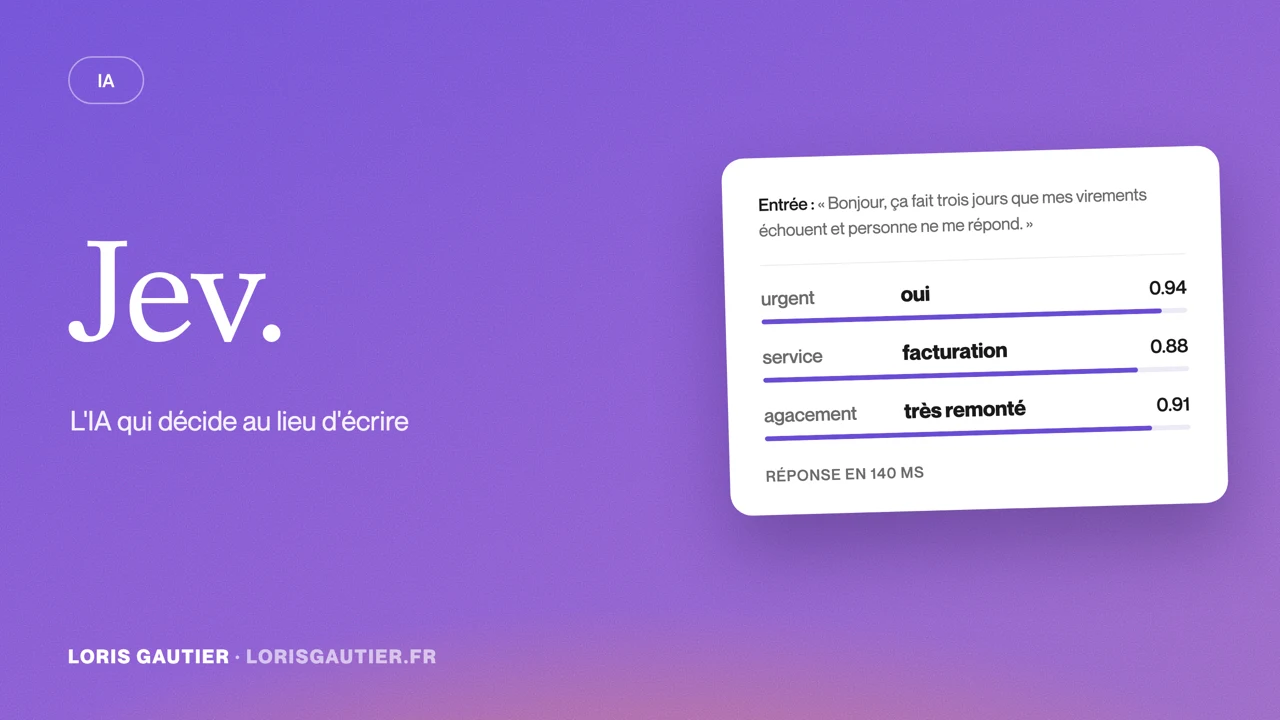
Depuis une semaine, un nom revient partout dans les fils tech : Jev. Et la première fois que j'ai lu la description, j'ai cru à une erreur. Un modèle d'intelligence artificielle qui n'écrit pas une seule phrase. Pas de réponse, pas de paragraphe, pas de résumé. Rien.
Ce n'est pas une erreur, c'est le principe. Jev ne rédige pas, il tranche. Tu lui donnes un texte et une question fermée, il te renvoie une décision et la probabilité qu'elle soit juste, en moins de deux dixièmes de seconde.
Ça paraît minuscule dit comme ça. Sauf que dans la plupart des automatisations que je construis chez mes clients, l'IA ne rédige rien du tout : elle trie, elle classe, elle route. Et pour ça, on payait jusqu'ici un moteur capable d'écrire un roman. Voilà ce que ça change, et comment l'essayer.
Jev : définition et principe
Non, Jev n'est pas un LLM. C'est la première chose à poser, parce que c'est là que tout le monde se trompe en lisant son nom dans un fil d'actualité.
Jev est un modèle sorti le 15 septembre 2026 par TypeSafe AI, une société américaine restée discrète pendant deux ans et cofondée par Diogo Almeida, un ancien chercheur d'OpenAI qui a travaillé sur ChatGPT. Un modèle de langage comme Claude ou GPT est fait pour produire du texte. Jev est fait pour produire une décision, et il ne sait faire que ça.
Concrètement, tu lui donnes un état, c'est à dire n'importe quel texte (un mail reçu, un message de client, une fiche produit, un journal d'erreurs), et une liste de questions fermées. Il te renvoie des réponses typées, chacune assortie de la probabilité qu'elle soit juste. Jamais une phrase.
TypeSafe range Jev dans une catégorie qu'ils ont créée pour l'occasion, les System One models, en référence aux travaux de Daniel Kahneman.
L'idée de Kahneman est simple. Notre cerveau a deux vitesses. Le Système 1 est le réflexe : tu reconnais un visage, tu sens qu'un mail est agressif, tu n'as rien calculé. Le Système 2 est le raisonnement posé : tu fais une division, tu construis un argumentaire, ça prend du temps et ça fatigue.
Les modèles de langage font du Système 2 en permanence. Même pour répondre « oui », ils déroulent la machinerie complète du raisonnement, mot après mot. C'est puissant, c'est lent, et c'est cher. Jev fait le Système 1 : il regarde, il tranche, il passe au suivant.
Petit détail qui en dit long sur leurs ambitions : le nom vient de William Stanley Jevons, l'économiste du paradoxe qui porte son nom. Quand une ressource devient beaucoup moins chère, on n'en consomme pas moins, on en consomme bien plus. Ils annoncent la couleur : selon eux, la décision automatisée va devenir assez peu coûteuse pour être mise partout.
Ce que Jev ne sait donc pas faire : rédiger une réponse, résumer un document, produire du code, expliquer son raisonnement. Tout ce qui est génératif reste le travail d'un modèle classique.
Comment fonctionne Jev ?
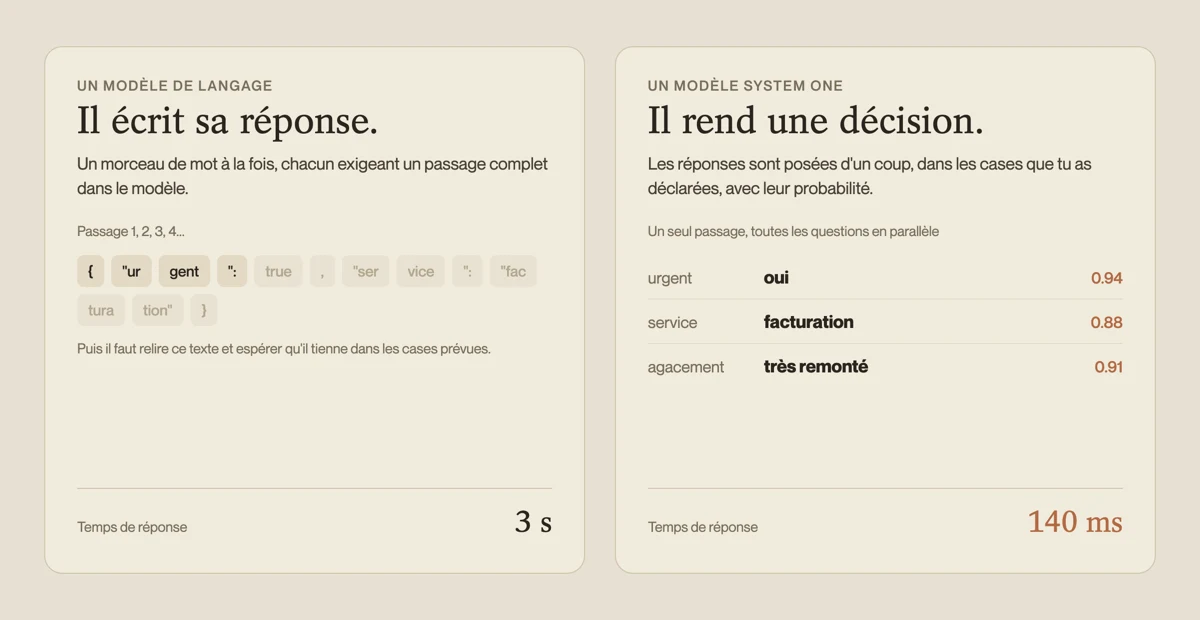
La différence technique tient à une chose : Jev n'écrit pas ses réponses lettre par lettre.
Un modèle de langage classique est autorégressif. Pour répondre « urgent », il produit un morceau de mot, le relit, produit le suivant, et recommence. Chaque morceau est un aller-retour complet dans le modèle. Trois caractères de réponse coûtent trois passages.
Jev fonctionne en une seule passe. Tu déclares tes options à l'avance, il pose une distribution de probabilité dessus, et il rend tout d'un coup. C'est ce qui donne des temps de réponse annoncés entre 70 et 500 millisecondes. Autre conséquence directe : comme toutes tes questions sont évaluées en parallèle sur le même texte, en poser une quatrième ne change quasiment rien au temps de réponse.
Les trois questions que Jev sait traiter
Trois formes de réponse sont possibles, et c'est tout :
| Type | Ce qu'il renvoie | Exemple de question |
|---|---|---|
noul | Une probabilité de oui entre 0 et 1 | « Ce message demande une action de ma part ? » |
choice | Une option parmi celles que tu listes, plus la probabilité de chacune | « Devis, réclamation, facture ou démarchage ? » |
score | Une position sur une échelle que tu définis | « Niveau d'urgence, de 1 à 5 » |
C'est volontairement pauvre. Tout l'art consiste à traduire une décision métier en questions fermées de ce type.
La probabilité calibrée
C'est le point que la plupart des articles survolent, et c'est pourtant le plus utile en production.
Un modèle de langage est sûr de lui en permanence, y compris quand il se trompe. Demande-lui son niveau de confiance, il te répondra 95 % avec le même aplomb quand il a raison et quand il invente.
TypeSafe a entraîné Jev différemment, avec une méthode maison qu'ils appellent RLCD, pour Reinforcement Learning for Calibrated Decisions. L'objectif n'est pas de produire une réponse qui plaît, mais une probabilité qui correspond à la réalité : une réponse donnée à 90 % doit être juste environ neuf fois sur dix.
En pratique, ça autorise quelque chose qu'on ne pouvait pas vraiment faire avant. Tu poses un seuil. Au dessus de 0,9, l'automatisation traite le cas toute seule. En dessous, elle le remonte à un humain ou à un modèle plus lourd. C'est la différence entre une automatisation qu'il faut surveiller et une automatisation qu'on peut laisser tourner.
À quoi ça sert concrètement ?
C'est la vraie question, et la réponse tient en une observation : dans une entreprise, la majorité des tâches qu'on confie à l'IA ne demandent pas d'écrire.
Trier une boîte mail. Séparer ce qui demande une action de ce qui doit juste être rangé, avec un niveau d'urgence. Un appel coûtant de l'ordre de deux centièmes de centime, faire passer trois cents mails par jour dans ce filtre revient à quelques centimes par mois.
Router les demandes entrantes. Un formulaire de contact, un message reçu, une demande de devis : identifier le sujet et la personne concernée avant que quiconque ouvre le message.
Qualifier des prospects. Traduire une grille de qualification en questions fermées, et obtenir un score avec son niveau de confiance plutôt qu'un jugement au fil de l'eau.
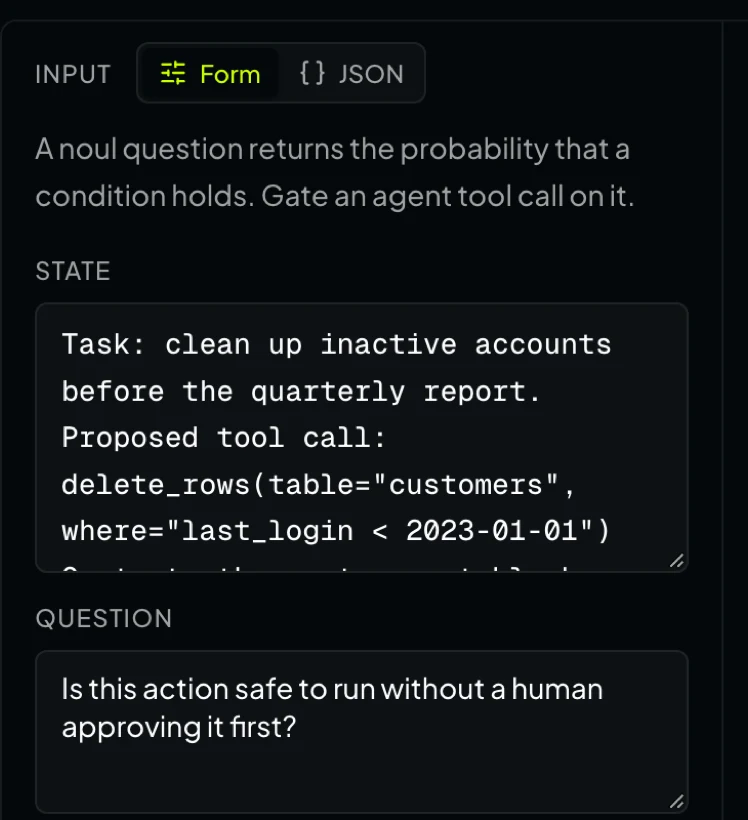
Servir de garde-fou. Vérifier qu'une action automatique est légitime avant de l'exécuter. C'est l'usage que mettent en avant plusieurs outils pour agents : un modèle rapide qui contrôle le travail d'un modèle lent.
Service par service
| Service | La décision à automatiser |
|---|---|
| Commercial | Qualifier un lead entrant, lui donner un score, l'aiguiller vers le bon interlocuteur |
| Support | Trier les tickets, repérer l'urgence et l'agacement, router vers la bonne équipe |
| Administratif et finance | Classer une pièce (devis, contrat, facture, relance), repérer une date ou un montant dans un document |
| Ressources humaines | Passer les candidatures sur des critères objectifs avant lecture humaine |
| Technique | Vérifier qu'une action automatique est légitime, valider la source qu'un agent s'apprête à utiliser |
Dans tous ces cas, le gain n'est pas que financier. Une décision qui tombe en 100 millisecondes peut se placer au milieu d'un processus, là où une attente de cinq secondes obligeait à tout passer en traitement différé.
Jev ou un LLM : lequel pour quelle tâche ?
C'est la question que tout le monde se pose, et la réponse n'est pas « Jev remplace ton modèle ». Elle tient en une ligne : si ta tâche produit du texte que quelqu'un va lire, garde ton LLM. Si elle produit une valeur que ton code va consommer, Jev est fait pour ça.
| La tâche | Le bon outil |
|---|---|
| Rédiger une réponse, un compte rendu, un devis | Claude ou GPT |
| Résumer un document, extraire une explication | Claude ou GPT |
| Raisonner sur un cas ambigu, arbitrer | Claude ou GPT |
| Classer, router, scorer, filtrer | Jev |
| Détecter une intention ou une urgence | Jev |
| Contrôler la sortie d'un autre modèle | Jev |
Ce que ça change sur la facture
Voici ce que coûte le tri de 100 000 emails, en prenant un mail moyen de 500 tokens en entrée et une réponse d'une dizaine de tokens. Les tarifs sont ceux publiés en septembre 2026.
| Modèle | Entrée et sortie par million de tokens | 100 000 emails triés |
|---|---|---|
| Jev | 0,042 $ et gratuit | 2,10 $ |
| GPT-5.6 Luna | 0,20 $ et 1,20 $ | 11,20 $ |
| Claude Haiku 4.5 | 1 $ et 5 $ | 55 $ |
| Claude Sonnet 5 | 2 $ et 10 $ | 110 $ |
| GPT-5.6 Terra | 2 $ et 12 $ | 112 $ |
| Claude Opus 5 | 5 $ et 25 $ | 275 $ |
Et c'est ici que je vais à contre-courant de ce que tu liras ailleurs. On répète que Jev est « jusqu'à 400 fois moins cher », et c'est vrai face aux modèles les plus lourds sur des tâches bavardes. Mais face à un petit modèle bien choisi, l'écart tombe à un facteur cinq. Si tu tries déjà tes emails avec un modèle léger, tu ne vas pas diviser ta facture par quatre cents, tu vas passer de onze dollars à deux.
Ce qui justifie vraiment le changement, ce n'est donc pas la facture, c'est ce que le petit modèle ne sait pas faire : tenir la latence sous la demi-seconde, garantir que la réponse reste dans ta liste, et te dire honnêtement quand il n'est pas sûr.
Les avantages et les limites de Jev
Ce qu'il apporte
La vitesse. Entre 70 et 500 millisecondes annoncées, contre plusieurs secondes pour un modèle classique sur la même tâche. Ça ouvre des usages en temps réel qui étaient hors de portée.
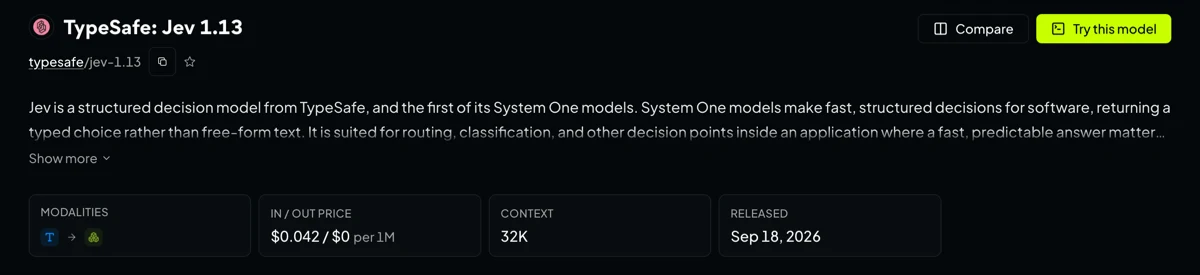
Le coût. 0,042 dollar par million de tokens en entrée, et la sortie est gratuite. Sur un texte court, un appel revient à environ 0,000018 dollar, soit de l'ordre de 55 000 appels pour un dollar.
La sortie toujours exploitable. La réponse est contrainte au format que tu as déclaré. Fini le JSON cassé, le « Voici la réponse : » collé devant, le champ qui manque. Si tu as déjà écrit du code pour rattraper la sortie d'un modèle, tu sais combien ce problème coûte de temps.
Le niveau de confiance, qui permet de poser un seuil plutôt que de tout valider à la main.
Deux entreprises ont publié leurs mesures à la sortie. Vercel classe ses alertes de sécurité 5 à 18 fois plus vite qu'avec le modèle d'OpenAI qu'ils utilisaient, avec une meilleure précision. Bryo AI trie ses emails professionnels 10 à 20 fois moins cher qu'avec Gemini, en récupérant au passage des scores de probabilité qu'ils n'avaient pas. Ce sont des chiffres d'utilisateurs, plus solides que ceux d'une page produit, mais mesurés sur leurs tâches à eux.
Ce qu'il ne fait pas
Il ne réfléchit pas. Pas de raisonnement en plusieurs étapes, pas de réflexion prolongée sur un cas difficile. Sur une question qui demande de peser le pour et le contre, un modèle classique reste meilleur.
Il n'est pas plus intelligent. Sur les évaluations publiées par TypeSafe, Jev atteint 67,8 % de précision, à égalité avec un modèle de la génération précédente et cinq à six points sous les meilleurs modèles du marché. Ce n'est donc pas un gain d'intelligence, c'est un arbitrage entre vitesse, prix et puissance. Et ces chiffres viennent du vendeur, à prendre comme tels.
« Zéro hallucination » est un raccourci marketing. Ce qui est garanti, c'est le format : le modèle ne peut pas répondre en dehors des options que tu lui as données. Sur le fond, il peut tout à fait classer un mail dans la mauvaise case. Il le fera simplement toujours dans une case valide. La nuance compte.
Texte uniquement. Ni image, ni audio, ni vidéo. La fenêtre de contexte est de 32 000 tokens, une question à choix accepte jusqu'à 255 options, et une échelle va de 2 à 10 niveaux.
Comment accéder à Jev ?
Trois voies, de la plus simple à la plus contraignante.
Par OpenRouter. C'est le chemin le plus court si tu as déjà un compte : aucune liste d'attente, le modèle s'appelle typesafe/jev-1.13, au même tarif que chez l'éditeur. La page du modèle embarque même un bac à sable avec trois exemples prêts à lancer, un par type de question. C'est la voie que je recommande pour un premier test.
Par TypeSafe en direct. Inscription sur la page de TypeSafe, puis attente d'une invitation. Tu récupères ensuite une clé et l'accès à un bac à sable qui permet de tester sans écrire une ligne de code. C'est le plus confortable pour se faire une idée à la main.
Par Cloudflare Workers AI, où le modèle est également référencé, pratique si ton infrastructure est déjà là bas.
Le piège à connaître
Jev ne passe pas par l'API de conversation habituelle. Il a son propre point d'entrée, encore marqué comme expérimental :
POST https://openrouter.ai/api/alpha/decisions
{
  "model": "typesafe/jev-1.13",
  "state": "Bonjour, ça fait trois jours que mes virements échouent et personne ne me répond.",
  "questions": {
    "urgent":      { "type": "noul" },
    "service":     { "type": "choice", "options": ["facturation", "technique", "commercial"] },
    "agacement":   { "type": "score",  "levels": ["Calme", "Contrarié", "Très remonté"] }
  }
}
Conséquence concrète : ta bibliothèque habituelle, celle qui parle aux modèles de conversation, ne fonctionnera pas dessus. Il faut un appel HTTP direct, ce qui reste une vingtaine de lignes sans aucune dépendance. Et le mot alpha dans l'adresse signifie que le format peut encore bouger, donc évite de bâtir un système critique dessus cette semaine.
FAQ
Jev est-il un LLM ?
Non. Un modèle de langage génère du texte mot après mot ; Jev ne génère rien et rend une décision typée en une seule passe. Ils partagent la famille technique des modèles entraînés sur du texte, pas l'usage.
Jev remplace-t-il ChatGPT ou Claude ?
Non, et ce n'est pas son objectif. Jev ne sait pas rédiger, résumer ni raisonner. Il se place en complément, sur les décisions rapides, pendant que le modèle génératif garde tout ce qui demande d'écrire.
Jev est-il open source ?
Non. Le modèle est propriétaire et accessible uniquement par API. Une réimplémentation ouverte du principe existe déjà dans l'écosystème, à partir d'un modèle de Google, ce qui laisse penser que l'approche sera copiée rapidement.
Combien coûte Jev exactement ?
0,042 dollar par million de tokens en entrée, la sortie étant gratuite, aussi bien chez TypeSafe que sur OpenRouter. Pour donner un ordre de grandeur, classer un mail revient à quelques centièmes de centime.
Faut-il savoir coder pour l'utiliser ?
Pour tester, non : le bac à sable d'OpenRouter, comme celui de TypeSafe, permet de coller un texte et de voir les décisions sortir. Pour l'intégrer à un outil, oui, il faut un appel HTTP, donc un minimum de développement.
Est-ce que ça vaut le coup d'attendre ?
Pour un usage critique en production, oui, le point d'entrée est encore expérimental. Pour tester sur tes propres données et voir si la qualité tient, non : une heure suffit, et c'est le seul moyen de savoir si ça marche sur ton métier.
Mon avis
Jev n'est pas une IA plus intelligente, c'est une IA moins bavarde. Et après une semaine à creuser le sujet, voilà où je me situe.
Ce qui m'intéresse vraiment, ce n'est pas la vitesse. C'est la probabilité calibrée. Une automatisation qui sait dire « je ne suis pas sûr » est une automatisation qu'on peut laisser tourner, et c'est le point qui bloque la moitié des projets que je vois. Tout le reste, la latence et le prix, c'est du confort.
Je ne construirais rien de critique dessus cette semaine. Le point d'entrée est marqué expérimental, la société a deux ans, et une réimplémentation ouverte du principe est apparue quatre jours après la sortie. Le nom Jev ne survivra peut-être pas à 2027. La catégorie, elle, restera : des modèles qui décident au lieu d'écrire, il va y en avoir chez tout le monde.
Et je me méfie du discours marketing. « Ne peut pas halluciner » est faux dès qu'on parle du fond, et les gains annoncés sortent des évaluations du vendeur. Ça reste un outil très bien fait pour une tâche étroite, pas une rupture.
Le meilleur moyen de te faire un avis à toi n'est pas de lire d'autres articles : prends dix vrais messages de ta boîte, passe les dans le bac à sable avec deux questions, et regarde si les réponses collent à ce que tu aurais décidé toi même. Tu sauras en un quart d'heure, et tu auras appris quelque chose sur ton propre tri autant que sur le modèle.
Si tu te demandes où ce genre de brique se place dans tes propres processus, c'est précisément le travail que je fais avec les dirigeants que j'accompagne : regarder ce qui se fait encore à la main, et décider ce qui mérite d'être automatisé.